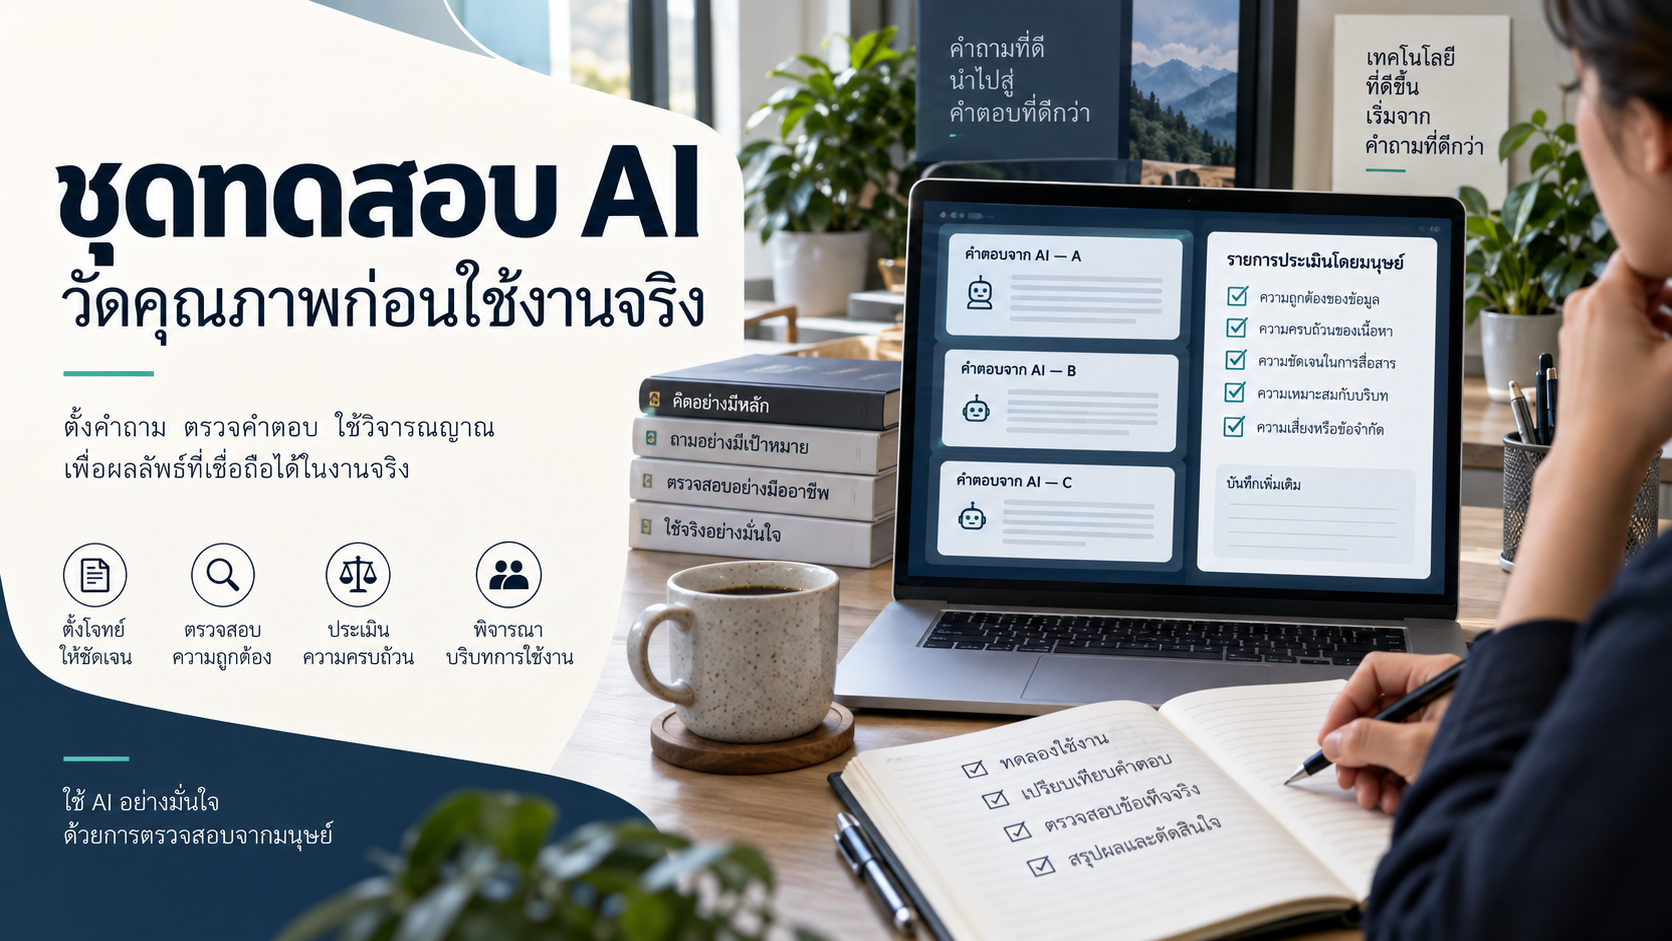
เมื่อองค์กรเปลี่ยนโมเดลหรือแก้คำสั่งให้ AI คำตอบที่ดูดีขึ้นเพียงไม่กี่ตัวอย่างยังไม่เพียงพอจะยืนยันว่าระบบพร้อมใช้งาน ชุดทดสอบที่ออกแบบจากงานจริงช่วยให้ทีมเปรียบเทียบระบบแต่ละรุ่นด้วยโจทย์เดียวกัน และเห็นว่าความสามารถด้านใดดีขึ้นหรือถอยหลัง ก่อนปล่อยให้ลูกค้าเป็นผู้พบปัญหา
ชุดทดสอบ AI ต่างจากการลองถามอย่างไร
การประเมินหรือ eval ประกอบด้วยข้อมูลนำเข้า ผลลัพธ์ที่ต้องการ และเกณฑ์ตรวจที่ชัดเจน ไม่จำเป็นต้องมีคำตอบต้นแบบเพียงประโยคเดียว เพราะงานเขียนและงานสนทนาอาจมีคำตอบที่ถูกต้องหลายรูปแบบ แนวทางของ Anthropic เรื่องการประเมิน AI แยกการตรวจด้วยโค้ด โมเดล และมนุษย์ รวมทั้งเน้นว่าควรตรวจผลที่เกิดขึ้นจริง ไม่ใช่เชื่อคำกล่าวของระบบเพียงอย่างเดียว
เริ่มจากงานเล็กที่มีเจ้าของชัดเจน
ตัวอย่างสมมติคือร้านอุปกรณ์สำนักงานที่ต้องการใช้ AI ช่วยร่างคำตอบเรื่องสถานะสินค้า ทีมอาจเลือกทดสอบเฉพาะงานนี้ก่อน โดยรวบรวมคำถามที่พบบ่อย ลบข้อมูลส่วนบุคคล แล้วเขียนว่าคำตอบที่ยอมรับได้ต้องมีอะไร เช่น ระบุวันที่อัปเดตสต็อก ไม่รับรองวันจัดส่งเมื่อยังไม่มีข้อมูล และส่งต่อเจ้าหน้าที่เมื่อรหัสสินค้าไม่ตรงกัน
ออกแบบกรณีธรรมดาและกรณีที่ต้องหยุด
สำหรับร้านสมมตินี้ ชุดงานควรมีทั้งสินค้าที่มีข้อมูลครบ สินค้าที่ชื่อใกล้กัน และคำถามที่ขาดรหัส การทดสอบเฉพาะคำถามง่ายอาจทำให้คะแนนสวยแต่ไม่สะท้อนงานหน้าร้าน ลองเพิ่มกรณีลูกค้าขอให้เดาวันส่ง หรือส่งข้อความที่ไม่เกี่ยวกับการสั่งซื้อ แล้วกำหนดการตอบที่สุภาพและไม่สร้างข้อเท็จจริงขึ้นเอง
ให้พนักงานสองคนตรวจคำตอบชุดเดียวกัน หากให้คะแนนต่างกัน ควรแก้เกณฑ์ให้ชัด เช่น เปลี่ยนคำว่า “ตอบดี” เป็น “บอกว่าข้อมูลไม่พอและขอรหัสสินค้า”
อ่านผลแยกประเภท ไม่ดูคะแนนรวมอย่างเดียว
สมมติระบบรุ่นใหม่ตอบเร็วขึ้น แต่ผิดในกรณีชื่อสินค้าคล้ายกันมากขึ้น ทีมควรเห็นข้อเสียนี้แยกจากคะแนนเฉลี่ย จัดรายงานเป็นกลุ่มงาน พร้อมตัวอย่างที่ไม่ผ่านและเหตุผล การผ่านงานทั่วไปจำนวนมากไม่ควรกลบข้อผิดพลาดที่ทำให้ลูกค้าได้รับข้อมูลสำคัญคลาดเคลื่อน
บันทึกวันที่ รุ่นโมเดล รุ่นคำสั่ง และชุดข้อมูลทุกครั้ง หากต้องใช้ AI ช่วยให้คะแนน ให้คนสุ่มตรวจเทียบเป็นระยะ และอย่าตัดสินจากการรันเพียงครั้งเดียว เพราะผลลัพธ์อาจต่างกันได้ การทดสอบที่ดีควรอธิบายได้ว่าระบบพลาดตรงไหน มากกว่ามีตัวเลขสูงไว้รายงาน
ทำให้ชุดทดสอบเติบโตพร้อมงาน
ทุกครั้งที่พบปัญหาใหม่ ให้พิจารณาเพิ่มโจทย์หลังตรวจและปกปิดข้อมูลแล้ว แต่เก็บชุดสำหรับตรวจขั้นสุดท้ายแยกจากตัวอย่างที่ใช้ปรับคำสั่ง เพื่อช่วยลดการปรับระบบให้จำเฉพาะโจทย์เดิม เริ่มจากกระบวนการเล็กที่ทีมตรวจได้จริง แล้วค่อยขยาย จะทำให้ชุดทดสอบเป็นเครื่องมือควบคุมคุณภาพที่ใช้ต่อเนื่องได้